 Lyssna
Examensarbete: Från ostrukturerad data till AI-driven kunskapsplattform
En konstant ökande mängd dokumentation i mjukvaruprojekt skapar stora utmaningar kring sökbarhet och kunskapsdelning. Att enbart lägga en språkmodell ovanpå ostrukturerad text löser inte problemet. Examensarbetet ska visa hur strukturerad kontext förbättrar precisionen i AI-driven sökning.
Bakgrund
I takt med att mjukvarusystem blir allt mer komplexa växer även mängden teknisk dokumentation. Information blir ofta utspridd över flera olika verktyg — från arkitekturbeskrivningar och systemdokumentation i Wiki lösningar, till user stories i ärendehanteringsverktyg och kodnära dokumentation i repositories för källkod. Informationen blir snabbt svårnavigerad, inaktuell och fragmenterad.
AI-stöd för sökningar kan vara en lösning. Exempelvis Retrieval-Augmented Generation (RAG) hjälper utvecklare att snabbt hitta svar i stora textmängder. RAG-modeller är dock helt beroende av kvaliteten på den data de indexerar. När kunskap lagras som ostrukturerad råtext i isolerade system uppstår problemet "garbage in, garbage out", vilket leder till dåligt resultat på sökningar eller rena hallucinationer.
För att låsa upp den fulla potentialen hos AI-driven sökning krävs därför en stabil grund av strukturerad data, tydliga objektmodeller och väldefinierade kopplingar mellan våra verktyg.
Problembeskrivning
Den konstant ökande mängden dokumentation i mjukvaruprojekt skapar stora utmaningar kring sökbarhet och kunskapsdelning, vilket gör att tröskeln blir hög att hitta rätt information.
Att enbart lägga en språkmodell (LLM) ovanpå ostrukturerad text löser inte problemet, eftersom AI-motorn får svårt att avgöra vilken information som är aktuell eller relaterad till rätt system.
Problemet har tre delar:
- Bristfällig informationsarkitektur i botten,
- Avsaknaden av ett AI-gränssnitt som nyttjar metadata för att ge exakta svar.
- Fragmentering mellan olika system, relaterad information kan hittas i källkoden, i wikilösningar eller i kanbankorten på tavlor.
Syftet med detta examensarbete är att överbrygga detta gap genom att skapa en helhetslösning. Genom att införa strukturerad datamodellering i våra wiki verktyg, automatiskt koppla samman metadata från källkodshantering och kanbanverktyg, samt bygga en RAG-pipeline, ska examensarbetet visa hur strukturerad kontext förbättrar precisionen i AI-driven sökning.
Mer information
Programvaror som nyttjas idag eller är aktuella vid ett systemskifte
- XWiki: En flexibel, open-source enterprise-wiki med starkt stöd för objektmodellering och dataklasser. Till skillnad från vanliga wikis tillåter XWiki att sidor berikas med strukturerade fält.
- GitLab: En komplett DevOps-plattform som hanterar källkod (Git), CI/CD-pipelines och kodgranskningar. I detta arbete fungerar GitLab som källkods och dokumentationsrepository, vilken kopplas samman med dokumentationssidorna i XWiki.
- Jira/OpenProject: System för projektstyrning och ärendehantering. Jira (proprietärt) och OpenProject (open-source) används för att spåra uppgifter, sprintar och systemstatus. Genom att hämta metadata och status från dessa verktyg via API:er berikas kontexten för systemdokumentationen i XWiki.
- Confluence: Atlassians proprietära enterprise-wiki. I detta exjobb utgör Confluence en viktig referenspunkt för traditionell, ofta ostrukturerad klartextdokumentation och användarupplevelse, vilken ställs i kontrast mot XWikis datadrivna struktur.
Område
- Generativ AI/RAG (Retrieval-Augmented Generation)
- Informationsarkitektur (IA) & Datamodellering
- Enterprise Wiki (XWiki/Confluence)
- DevOps-verktyg (GitLab)
- Kanbanverktyg(Jira/OpenProject)
- Knowledge Management & Semantisk sökning
- UX & Användarupplevelse
Kompetens
Nivå: Masteruppsats 30 hp (en eller två studenter)
Lämpliga utbildningar: Civilingenjör inom Datateknik eller Systemvetenskap.
Teknisk kompetens & Färdigheter
Programmering: Goda kunskaper i språk som Python, Java, JavaScript/TypeScript eller liknande. Erfarenhet av att arbeta med REST-API:er, JSON och integrationer mellan olika system (exempelvis för att hämta data från GitLab eller Jira).
Systemvetenskapligt tänk: Förståelse för Knowledge Management – hur dokumentation, arbetsflöden och kunskapsdelning fungerar i ett IT-team.
AI-ramverk: Grundläggande förståelse för språkmodeller (LLM:er), RAG-pipelines och hur information indexeras för semantisk sökning.
Arbetets faser
Beroende på studentens ambition och om de vill dela jobbet med flera studenter kan det struktureras i följande faser där de kan utföra hela eller delar av jobbet
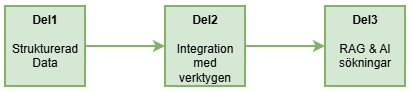
Skall-krav (Del 1): Utan bra struktur på datan fungerar varken sökning eller AI särskilt bra ("garbage in, garbage out"). Studenten/studenterna börjar med att bygga upp en struktur av klasser och mallar för vår dokumentation. Bygga XWiki-datastrukturen samt indexera den för basala sökningar och enklare RAG-prototyp.
Bör-krav (Del 2): När dokumentationen har strukturerade fält kan dessa användas för att knyta ihop information över olika verktyg för att berika RAG kontexten.
Kan-krav (Del 3): Med strukturerad och berikad data på plats är det dags att bygga en RAG-lösning. Språkmodellen får inte bara råtext, utan kan använda strukturerade metadata från wikin för att ge betydligt mer exakta svar med direkta källhänvisningar. Avancerat UI i XWiki med realtidschatt, federerad sökning mot GitLab-API i samma gränssnitt.
Förslag på tidsfördelning för 2 studenter (20 veckor totalt):
- Vecka 1–5: Datamodellering i XWiki + Litteraturstudie (IA & RAG).
- Vecka 6–12: Bygga integrationer, vektorindexering och RAG-pipeline.
- Vecka 13–16: UX-utvärdering med era utvecklare (kvalitativa tester/enkäter).
- Vecka 17–20: Rapportskrivning och presentation.